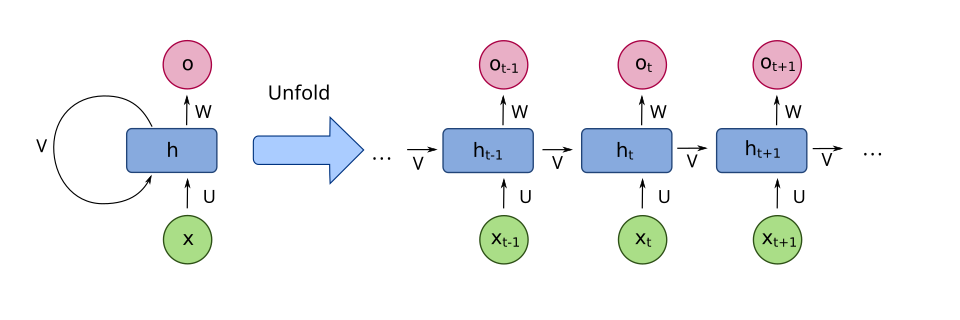
Le vendredi 19 mai 2017, à treize heures, heure de Mountain View, le serveur de la conférence NIPS cesse d'accepter les soumissions. Quelques nuits avant la date limite, le manuscrit n'a pas encore de titre. Llion Jones, un Gallois arrivé chez Google par YouTube, fait remarquer que l'équipe a jeté toutes les bonnes pratiques du moment pour n'en garder qu'une : l'attention. Les Beatles avaient bien chanté « All You Need Is Love ». Le papier s'appellera « Attention Is All You Need ». Huit auteurs, et au bas de la première page, un astérisque.
L'astérisque renvoie à une note de bas de page.
Contribution égale. L'ordre des noms est aléatoire.
Dans la recherche, où la place de premier auteur se négocie comme un héritage, huit personnes ont tiré leurs noms au sort. Le PDF est mis en ligne sur arXiv le 12 juin 2017. Moins de dix ans plus tard, il est l'un des articles scientifiques les plus cités du siècle.
Lire avec le doigt
Le schéma en tête de cette note montre l'adversaire : un réseau de neurones récurrent, l'outil standard de la traduction automatique en 2017 ; Google Translate venait de basculer sur cette famille de modèles en 2016. La machine lit comme un enfant qui suit la ligne avec le doigt, un mot après l'autre, en gardant en tête un résumé de ce qu'elle a lu. Chaque nouveau mot efface un peu le précédent. Au bout de trente mots, le début de la phrase est devenu une rumeur.
Ce défaut a un prix concret. Dans « The animal didn't cross the street because it was too tired », le mot « it » désigne l'animal. Avec « wide » à la place de « tired », il désigne la rue. Pour traduire en français, il faut relier « it » au bon nom, six mots plus haut, et un lecteur au doigt a déjà commencé à oublier. Jakob Uszkoreit, ingénieur chez Google Research, soupçonne depuis un moment que l'attention seule pourrait suffire, sans lecture séquentielle. Son propre père, Hans Uszkoreit, linguiste informaticien reconnu, trouve l'idée douteuse.
Des fils tendus entre tous les mots
La solution s'appelle l'attention, et une table suffit à la décrire. On pose la phrase entière sur une table, tous les mots en même temps. Chaque mot porte une étiquette qui dit ce qu'il est, et tient une petite pancarte qui dit ce qu'il cherche. « It » cherche un sujet au singulier capable d'être fatigué. On tend un fil de « it » vers chaque autre mot, et l'épaisseur du fil dépend de l'accord entre la pancarte et l'étiquette. Le fil vers « animal » devient une corde, le fil vers « the » reste un cheveu. Le sens de « it » est recomposé en tirant sur chaque fil proportionnellement à son épaisseur. On refait l'opération pour chaque mot, plusieurs fois, avec plusieurs jeux de fils, et la phrase finit par se comprendre elle-même. Le papier appelle cela « self-attention ».
Le point décisif n'est pas l'élégance, c'est le chronomètre. Un lecteur au doigt doit attendre le mot sept pour lire le mot huit. Une table où tous les fils se tendent en même temps se calcule d'un seul coup sur une carte graphique, faite pour des milliers d'opérations identiques en parallèle. L'équipe entraîne son plus gros modèle, 213 millions de paramètres, autant de réglages internes ajustés pendant l'apprentissage, en trois jours et demi sur huit cartes NVIDIA P100. La version de base s'entraîne en douze heures. Et le résultat bat tout ce qui existe en traduction anglais-allemand sur le banc d'essai WMT 2014, un lot de phrases accompagnées d'une traduction humaine de référence. Le score BLEU, qui mesure la ressemblance avec cette référence, atteint 28,4, deux points au-dessus des meilleurs ensembles de modèles.
Huit noms tirés au sort
La note de bas de page continue, et elle est la seule archive honnête de qui a fait quoi. Jakob Uszkoreit a proposé de remplacer les réseaux récurrents par l'attention. Ashish Vaswani et Illia Polosukhin ont conçu et codé les premiers modèles. Noam Shazeer, chez Google depuis 2000, a inventé la forme exacte du calcul, l'attention « multi-têtes », et s'est retrouvé mêlé à presque chaque détail. Niki Parmar a conçu et testé d'innombrables variantes. Llion Jones tenait le code de départ et les visualisations. Łukasz Kaiser et Aidan Gomez ont réécrit toute la bibliothèque logicielle, Tensor2Tensor, au prix, dit la note, « d'innombrables longues journées ».
Gomez avait vingt ans. Il était stagiaire, étudiant à l'Université de Toronto, et c'est l'adresse de l'université, pas celle de Google, qui figure sous son nom. Polosukhin signe avec une adresse Gmail et une mention en marge, « travail effectué chez Google Research » : quand le papier sort, il est déjà parti monter NEAR, une start-up d'IA devenue blockchain. Le nom, Transformer, vient d'Uszkoreit, qui aimait sa sonorité ; un premier document de conception montrait les robots-jouets du même nom.
Long Beach, décembre 2017
Le papier est accepté. Il est présenté à la 31e conférence NIPS, au Long Beach Convention Center, en Californie, du 4 au 9 décembre 2017 ; dans les actes, il tient en onze pages. Dès le 31 août, Uszkoreit l'avait expliqué sur le blog de recherche de Google, avec l'histoire de l'animal et de la rue. Google tient l'architecture, le code et les auteurs. La suite est connue. En juin 2018, OpenAI publie GPT-1, et le T de GPT signifie Transformer. La même année, Google sort BERT, un Transformer lui aussi. En mai 2020, GPT-3 compte 175 milliards de paramètres, huit cents fois le modèle de 2017. Fin 2022, ChatGPT met un Transformer dans toutes les mains.
Aujourd'hui, le fait se vérifie sur les fiches : GPT, Claude, Gemini et Llama sont des Transformers. C'est le T de GPT ; Claude est une famille de « generative pre-trained transformers », Gemini un ensemble de « decoder-only transformers ». Le premier Llama, que Meta publie en février 2023, est « fondé sur l'architecture transformer », avec un renvoi au papier de 2017. Les images, l'audio, la robotique et même les échecs y sont passés. Google Scholar recense plus de 280 000 citations au 3 octobre 2026, de quoi le placer parmi les dix articles les plus cités du XXIe siècle. Le titre a fait des petits : une étude déposée sur arXiv en décembre 2025 compte 717 prépublications en « All You Need », dont 200 pour la seule année 2025.
Tous partis
Google a payé l'idée, les machines et les salaires, puis a regardé les huit auteurs sortir un par un. Polosukhin est parti le premier, avant même la publication. Gomez quitte Google Brain en 2019 pour fonder Cohere, qu'il dirige. En 2021, c'est l'hémorragie : Uszkoreit monte Inceptive, une biotech de Palo Alto qui conçoit des molécules d'ARN ; Kaiser rejoint OpenAI ; Vaswani s'en va, et fondera Essential AI avec Niki Parmar ; Shazeer, vingt et un ans de maison, claque la porte parce que Google refuse de rendre public son agent conversationnel, et fonde Character.AI.
Le dernier à sortir est Llion Jones, à l'été 2023. Il part à Tokyo fonder Sakana AI avec David Ha, et donne à CNBC une explication sans fard.
Je crois que la bureaucratie avait grossi au point que j'avais le sentiment de ne plus rien pouvoir faire aboutir.
Shazeer mérite une ligne de plus. En août 2024, Google paie 2,7 milliards de dollars pour une licence sur la technologie de Character.AI, surtout pour ramener Shazeer à la codirection de Gemini. En juin 2026, toujours selon la presse, il annonce son départ pour OpenAI. Même en rachetant son propre auteur, Google ne l'a gardé que deux ans.
Le schéma qui ne savait pas
Reste le dessin en haut de cette page. Un réseau récurrent, avec sa boucle qui ramène l'état caché vers lui-même, puis la même boucle « dépliée » dans le temps, pas à pas, le doigt sur la ligne. Il a été déposé sur Wikimedia Commons le 19 juin 2017 par un contributeur qui voulait expliquer l'état de l'art. Sept jours plus tôt, huit personnes avaient mis en ligne le papier qui le rendait obsolète. Le schéma est resté exact. Il décrit, avec beaucoup de clarté, la façon dont les machines ne lisent plus.