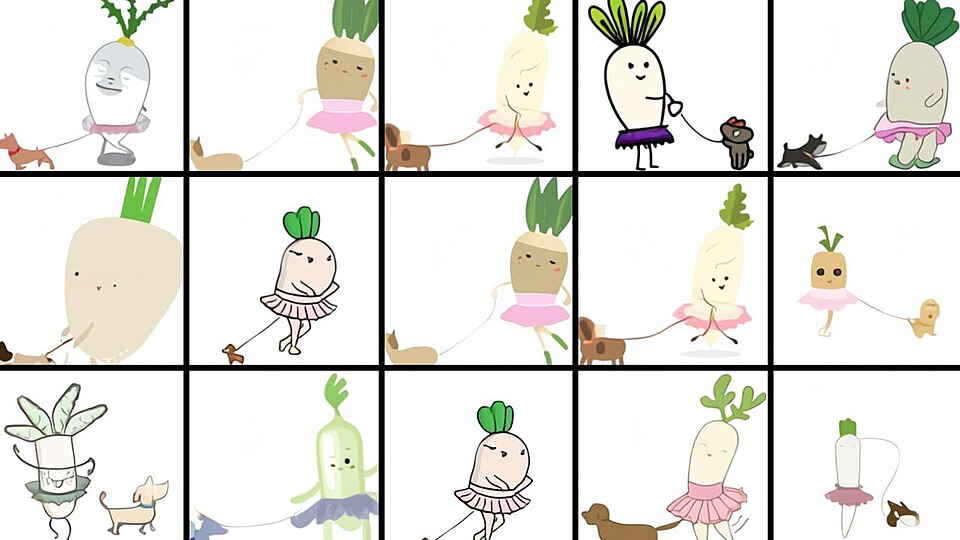
Le radis porte un tutu rose. Il tient une laisse, et au bout de la laisse trotte un petit chien qui ne semble pas surpris. Le 5 janvier 2021, OpenAI publie sur son blog des dizaines de variantes de cette scène, toutes dessinées par une machine à partir d'une seule phrase en anglais : « an illustration of a baby daikon radish in a tutu walking a dog », l'illustration d'un bébé radis daikon en tutu qui promène un chien. Le système s'appelle DALL-E, mot-valise entre Salvador Dalí et WALL-E, le petit robot de Pixar.
Le même jour, l'entreprise présente un second modèle, CLIP, moins spectaculaire et tout aussi important pour cette histoire. Le premier dessine. Le second choisit ce que le public a le droit de voir.
Un fauteuil en forme d'avocat
L'exemple qui fait le tour de la presse n'est pas le radis, c'est un meuble. La consigne « an armchair in the shape of an avocado », un fauteuil en forme d'avocat, donne des fauteuils à haut dossier qui ressemblent à des avocats coupés en deux, le noyau en guise de coussin. Aditya Ramesh, qui a dirigé la création de DALL-E, le raconte au MIT Technology Review.
Ce qui m'a le plus surpris, c'est que le modèle peut prendre deux concepts sans rapport et les assembler d'une manière qui donne quelque chose d'à peu près fonctionnel.
DALL-E est, selon OpenAI, une version de GPT-3 à 12 milliards de paramètres, autant de réglages internes, entraînée non plus sur du texte seul, mais sur des paires texte-image. Le papier technique de ses huit auteurs, mis en ligne sur arXiv le 24 février 2021, donne l'échelle : 250 millions de paires récoltées sur Internet, digérées par 1 024 cartes graphiques Nvidia V100 au fil de 430 000 étapes d'entraînement.
Une image, c'est 1 024 tesselles
Chaque image d'entraînement est réduite à 256 pixels de côté, puis découpée en une grille de 32 cases sur 32. Un premier réseau, un autoencodeur, résume chaque case par un code choisi dans un catalogue de 8 192, comme on pioche une tesselle dans une boîte. Une image devient une suite de 1 024 codes, exactement comme une phrase est une suite de mots.
Le second réseau, un Transformer, fait alors ce que fait GPT-3 avec le texte. Il lit la légende, jusqu'à 256 jetons, des morceaux de mots, puis devine la première tesselle, puis la suivante, ligne après ligne, 1 024 fois. Un décodeur retraduit enfin les codes en pixels. La machine ne peint pas : elle complète une phrase dont la fin se trouve être un dessin.
Cette logique de complétion produit un effet que ses auteurs n'avaient pas prévu. Donnez-lui le haut d'une photo de chat et la consigne « exactement le même chat en haut, en croquis en bas » : elle dessine dans la moitié inférieure un croquis d'un chat semblable. OpenAI écrit n'avoir « pas anticipé » cette capacité. Le billet avoue aussi les ratés : plus la consigne contient d'objets, plus la machine confond quel objet porte quelle couleur, et le taux de réussite « chute brutalement ». Pour « un vitrail représentant une fraise bleue », le MIT Technology Review relève aussi des fenêtres bleues avec des fraises rouges.
Le juge s'appelle CLIP
CLIP a appris autrement. On lui a montré 400 millions d'images trouvées sur Internet avec leur légende, et on lui a posé sans relâche la même devinette : parmi 32 768 bouts de texte tirés au hasard, lequel accompagnait vraiment cette image ? À force, il sait dire si une image et une phrase vont ensemble.
OpenAI s'en sert comme d'un jury. Pour chaque consigne, DALL-E produit 512 images ; CLIP les classe et ne garde que les 32 meilleures. Ce sont elles qui s'affichent sur le blog, sans tri à la main, précise l'entreprise, sauf pour les vignettes et les images isolées. Le public découvre donc un peu plus de 6 % de chaque fournée, sélectionnés par une autre machine.
Mark Riedl, chercheur en créativité computationnelle à Georgia Tech, salue les exemples et garde un doute précis. Il se dit « un peu méfiant » envers le radis, dont le style laisse penser que le modèle « a peut-être mémorisé des dessins d'Internet ». Une recherche rapide, note-t-il, fait remonter quantité de radis daikon humanisés en dessin animé.
Un menu déroulant pour tout le monde
En janvier 2021, DALL-E n'est ouvert à aucun utilisateur extérieur. Rachel Metz, de CNN Business, écrit qu'OpenAI n'a pas encore décidé comment ni quand le diffuser, et que sa rédaction n'a pas pu l'essayer. La seule façon d'y toucher est un jeu de menus déroulants sur la page du blog : on remplace « un fauteuil en forme d'avocat » par « une horloge en forme de Rubik's Cube », en choisissant les mots dans une liste fermée.
Fin février, OpenAI publie du code sur GitHub. C'est l'autoencodeur, la boîte de tesselles. La notice précise que le Transformer qui passe du texte à l'image ne fait pas partie de la publication. Le billet du 5 janvier avait déjà nommé l'inquiétude qu'on prête volontiers aux artistes.
À l'avenir, nous prévoyons d'analyser comment des modèles comme DALL-E touchent à des questions de société : l'impact économique sur certains processus de travail et certaines professions, le risque de biais dans ce que produit le modèle, et les défis éthiques à plus long terme qu'implique cette technologie.
En janvier 2021, cette crainte est donc écrite par l'éditeur lui-même, dans son propre communiqué. La grande vague de contestation des artistes attendra des outils que le public peut enfin utiliser.
Vermeer, les mèmes et la colère : 2022
Ce que la mémoire collective range sous « DALL-E, 2021 » s'est surtout joué l'année suivante, et souvent ailleurs. Le 6 avril 2022, OpenAI annonce DALL-E 2, avec une résolution quatre fois plus élevée ; parmi les exemples, un astronaute à cheval en style photoréaliste. Le 20 juillet, la bêta commence à envoyer des invitations à un million de personnes inscrites sur liste d'attente. Le 31 août, OpenAI présente l'outpainting, qui prolonge une image au-delà de son cadre, illustré par August Kamp avec La Jeune Fille à la perle de Vermeer, agrandie par la machine. Le 28 septembre, la liste d'attente disparaît.
Les mèmes ne viennent pas d'OpenAI. En juillet 2021, pendant une semaine de projets communautaires organisée par Hugging Face avec Google, Boris Dayma et une petite équipe construisent DALL-E mini, une réimplémentation libre vingt-sept fois plus petite que l'original. Début juin 2022, après plusieurs améliorations, elle déferle sur Twitter, et ses grilles de neuf images, souvent absurdes, circulent comme des blagues. OpenAI demande un changement de nom ; DALL-E mini devient Craiyon.
La colère, elle, a une adresse : Théâtre D'opéra Spatial, l'image de Midjourney avec laquelle Jason M. Allen remporte un premier prix à la foire de l'État du Colorado, fin août 2022, une affaire que raconte la note de 2022. L'outil en cause n'est pas DALL-E.
Un radis sans auteur
Le 5 septembre 2023, le Bureau américain du droit d'auteur refuse définitivement d'enregistrer l'image de Jason Allen, au nom d'une règle qui exclut les œuvres produites par des non-humains. Wikimedia Commons applique la même logique au radis. L'image de la frise, quinze des dessins publiés en janvier 2021, y figure dans le domaine public, parce qu'elle est l'œuvre d'un algorithme et ne contient pas assez de création humaine pour fonder un droit d'auteur.
Le défaut avoué en 2021 a eu la vie longue. Le 25 mars 2025, quand OpenAI intègre la génération d'images à GPT-4o, son annonce précise que d'autres systèmes peinent dès 5 à 8 objets, et que le nouveau en gère jusqu'à 10 à 20. Le Transformer qui dessinait les radis n'a pas été publié.
Le radis tient toujours sa laisse, il porte toujours son tutu, et il n'appartient à personne.