En 2012, dans la chambre d'Alex Krizhevsky, chez ses parents, un ordinateur tourne sans s'arrêter. À l'intérieur, deux cartes graphiques GeForce GTX 580, des cartes de joueur, trois gigaoctets de mémoire chacune. Elles chauffent cinq à six jours d'affilée. Le programme qu'elles exécutent regarde 1,2 million de photographies, une par une, environ quatre-vingt-dix fois de suite, et apprend à dire ce qu'il y a dessus. Un chat. Un acarien. Krizhevsky est doctorant à l'université de Toronto. Son camarade de laboratoire, Ilya Sutskever, l'a convaincu de s'attaquer au concours ImageNet. Leur directeur de thèse, Geoffrey Hinton, soixante-quatre ans, attend depuis 1986 que quelqu'un prouve que ses réseaux de neurones ne sont pas une impasse.
Trente ans sur la touche
Au début des années 1970, l'idée d'imiter grossièrement des neurones avec des additions et des multiplications avait été écartée par la plupart des chercheurs en intelligence artificielle. Le 9 octobre 1986, Hinton signe avec David Rumelhart et Ronald Williams un article de quatre pages dans Nature, « Learning representations by back-propagating errors ». La rétropropagation : on montre un exemple au réseau, on mesure l'écart entre sa réponse et la bonne, et on fait remonter cet écart couche par couche pour corriger chaque connexion d'un cheveu. Répété des millions de fois, le geste finit par régler la machine. La méthode existait sous d'autres plumes ; ce papier la rend populaire.
Populaire ne veut pas dire respectée. Pendant deux décennies, les réseaux de neurones restent une spécialité de marge : trop lents, trop gourmands en données, impossibles à expliquer. Yann LeCun, qui entraîne des réseaux convolutifs depuis 1988, d'abord chez Bell Labs, et dont le lecteur de chèques a été déployé par NCR, annonce en 2012 qu'il n'enverra plus de papier sur le sujet à CVPR, la grande conférence de vision par ordinateur, après une longue série de refus : « une perte de temps pour tout le monde ».
Quatorze millions d'images étiquetées à la main
Une jeune professeure de Princeton décide que le problème n'est pas le modèle, mais les données. Fei-Fei Li lance ImageNet en 2007 : prendre les quelque 22 000 noms communs de WordNet, un dictionnaire hiérarchique de l'anglais, et trouver pour chacun des centaines de photos. Elle passe par Amazon Mechanical Turk : entre juillet 2008 et avril 2010, environ 49 000 travailleurs répartis dans 167 pays trient plus de 160 millions d'images candidates. Le résultat est présenté en 2009 à la conférence CVPR, en Floride, sur un simple poster. À terme, plus de 14 millions d'images annotées, plus de 20 000 catégories.
À partir de 2010, ImageNet organise un concours annuel, l'ILSVRC : 1 000 catégories, 1,2 million d'images d'entraînement, et une notation indulgente dite « top-5 », où la machine a droit à cinq propositions et ne se trompe que si la bonne étiquette n'y figure pas. En 2010, le vainqueur se trompe encore sur 28,2 % des images. En 2011, sur 25,8 %.
Des couches, des filtres et un chat
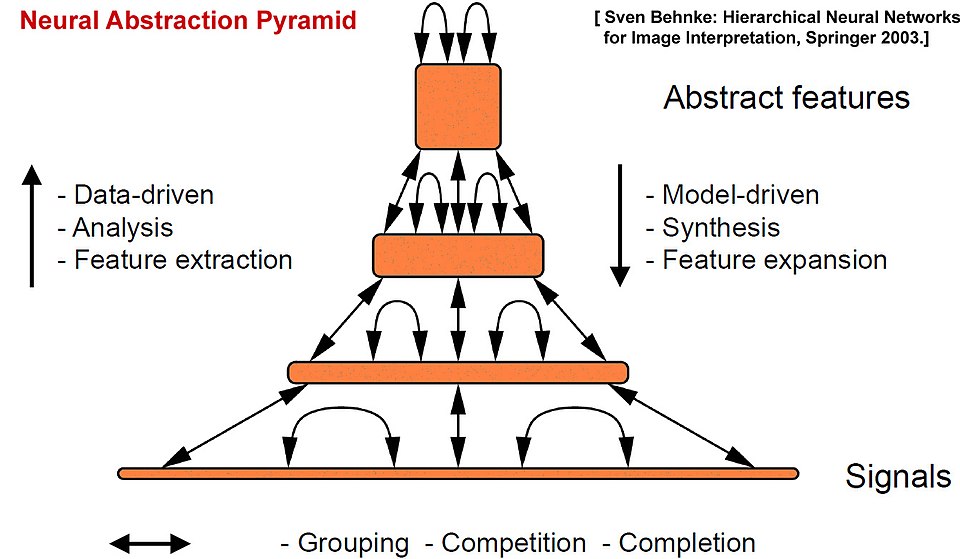
Le réseau de Krizhevsky compte huit couches : cinq couches de convolution, puis trois couches entièrement connectées. Soixante millions de paramètres, les réglages de ses connexions, et 650 000 neurones. Une couche de convolution, c'est une batterie de petits filtres, des carrés de quelques pixels, que l'on fait glisser sur toute l'image. Les premiers n'apprennent que des choses simples : un bord vertical, une tache orange. La couche suivante combine ces réponses en motifs plus riches, une texture de fourrure. Celle d'après assemble les motifs en morceaux d'objets : une oreille pointue, un œil rond. Tout en haut, les trois dernières couches tranchent entre mille étiquettes. Aucun programmeur n'écrit la règle « un chat a deux oreilles pointues » : les filtres se règlent eux-mêmes, par rétropropagation, à force de voir des chats et d'être corrigés.
Rien de tout cela n'est neuf. Ce qui est neuf, c'est l'échelle, et trois choix : une fonction d'activation plus franche, ReLU, qui transmet tel quel un signal positif et ramène le reste à zéro ; le « dropout », qui éteint au hasard la moitié des neurones à chaque passage pour empêcher le réseau d'apprendre par cœur ; et deux cartes graphiques, les GPU, au lieu d'un processeur. Le réseau est trop gros pour les trois gigaoctets d'une seule GTX 580, alors Krizhevsky le coupe en deux moitiés qui ne se parlent qu'à certaines couches. Les puces conçues pour afficher des explosions calculent exactement ce qu'il faut : des multiplications de matrices, en parallèle.
Toutes nos expériences suggèrent que nos résultats peuvent être améliorés simplement en attendant que des GPU plus rapides et des jeux de données plus grands deviennent disponibles.
La phrase clôt l'introduction du papier. Elle paraît modeste. C'est le programme des quinze années suivantes.
Florence, octobre 2012
L'équipe de Toronto dépose son entrée pour le 30 septembre 2012 sous le nom SuperVision. Fei-Fei Li racontera avoir reçu un soir le message d'un de ses doctorants : un résultat « qui sort vraiment du lot ». Les résultats complets sont publiés le 13 octobre, au lendemain de leur présentation à l'atelier ImageNet de la conférence ECCV, à Florence. SuperVision : 15,3 % d'erreur top-5. Le deuxième, une équipe de l'université de Tokyo, 26,2 %. Oxford, 27,0 %. D'habitude, le classement se joue à quelques points ; là, l'écart fait près de onze points, et le vainqueur est le seul à ne pas utiliser les méthodes classiques.
Dans la salle, LeCun parle d'un « tournant sans équivoque dans l'histoire de la vision par ordinateur ». Quatre mois plus tôt, Google avait fait la une avec un réseau capable de repérer des chats dans des vidéos YouTube : 16 000 cœurs de processeur, un millier de machines, trois jours de calcul sur dix millions d'images. Toronto fait mieux avec deux cartes de joueur dans une chambre. Google va s'en souvenir.
Une enchère dans la chambre 731
En décembre 2012, la conférence NIPS se tient au casino Harrah's de Lake Tahoe, dans le Nevada. Hinton, Krizhevsky et Sutskever viennent de fonder DNNresearch : trois personnes, aucun produit. Selon le récit du journaliste Cade Metz, Hinton organise depuis la chambre 731 une enchère par courrier électronique entre Baidu, Google, Microsoft et DeepMind. Les offres grimpent jusqu'à 44 millions de dollars. Là, Hinton arrête l'enchère et choisit Google. L'homme ne s'assoit plus depuis 2005 à cause d'une vieille blessure au dos ; il a mené la négociation sans prendre une chaise. Le rachat est annoncé le 12 mars 2013.
Ce qui s'est passé ensuite
L'année suivante, à l'ILSVRC 2013, les dix premières équipes utilisent toutes des réseaux convolutifs profonds. Le vainqueur, Clarifai, descend à 11,2 % d'erreur. En 2014, GoogLeNet passe sous les 7 %. En 2015, un réseau de Microsoft Research fait mieux que les humains testés sur la même tâche, et le concours s'arrête après l'édition 2017. Le Computer History Museum résumera : avant AlexNet, presque aucun des grands papiers de vision par ordinateur n'utilisait de réseau de neurones ; après, presque tous.
Sutskever quitte Google fin 2015 pour cofonder OpenAI, dont il devient le directeur scientifique. Krizhevsky quitte Google en septembre 2017, par lassitude, et s'éloigne des projecteurs. Cette même année, huit chercheurs de Google publient l'architecture Transformer, qui portera les grands modèles de langage. Hinton reçoit le prix Turing 2018 avec LeCun et Yoshua Bengio, annoncé le 27 mars 2019, puis, le 8 octobre 2024, le prix Nobel de physique, partagé avec John Hopfield, « pour des découvertes et inventions fondamentales qui permettent l'apprentissage automatique avec des réseaux de neurones artificiels ».
Ilya a pensé qu'il fallait le faire, Alex l'a fait marcher, et moi j'ai eu le prix Nobel.
La phrase est de Hinton, rapportée par le Computer History Museum. Le 20 mars 2025, le musée, avec Google, après cinq ans de négociation, publie sur GitHub le code source original d'AlexNet. Le papier qui l'accompagne a été cité plus de 170 000 fois. Dans le code, ni formule magique ni théorie nouvelle. Il y a la rétropropagation de 1986, quatorze millions d'images étiquetées par 49 000 inconnus, et deux cartes de joueur qui ont chauffé cinq jours dans une chambre.