Une bande de papier étroite avance par à-coups dans un Teletype Model 33. À chaque pas, la machine y poinçonne jusqu'à huit trous en ligne. Sept d'entre eux codent le caractère ; le huitième, la parité, sert à repérer une erreur de lecture. Dix caractères par seconde, en majuscules seulement. Le Model 33 sort en 1963, l'année de la norme qu'il est l'un des premiers à appliquer, et il en sortira plus d'un demi-million avant 1975. Ces sept trous portent un nom : ASCII, American Standard Code for Information Interchange. Ils vont décider, pour soixante ans et plus, de la façon dont une machine écrit le mot « machine ».
Soixante façons d'écrire la lettre A
Avant cette bande, chaque constructeur range l'alphabet à sa manière, et un ruban perforé sur une machine est illisible sur la voisine. Bob Bemer, qui dirige alors les standards de programmation chez IBM, les a comptées.
Nous avions plus de soixante façons différentes de représenter les caractères dans les ordinateurs. C'était une vraie tour de Babel.
Bemer représente IBM au sous-comité X3.2 de l'American Standards Association, l'organisme de normalisation américain de l'époque. Le groupe commence ses travaux en 1960 ; Bemer dépose sa proposition en mai 1961. Il fera entrer dans la norme trois choses qui lui survivront : la barre oblique inverse, les accolades et un caractère d'échappement, le code 0011011, pour passer d'un alphabet à un autre. Vingt-cinq mois de débats plus tard, la norme ASA X3.4-1963 paraît ; on retient la date du 17 juin 1963.
Sept trous, pas huit
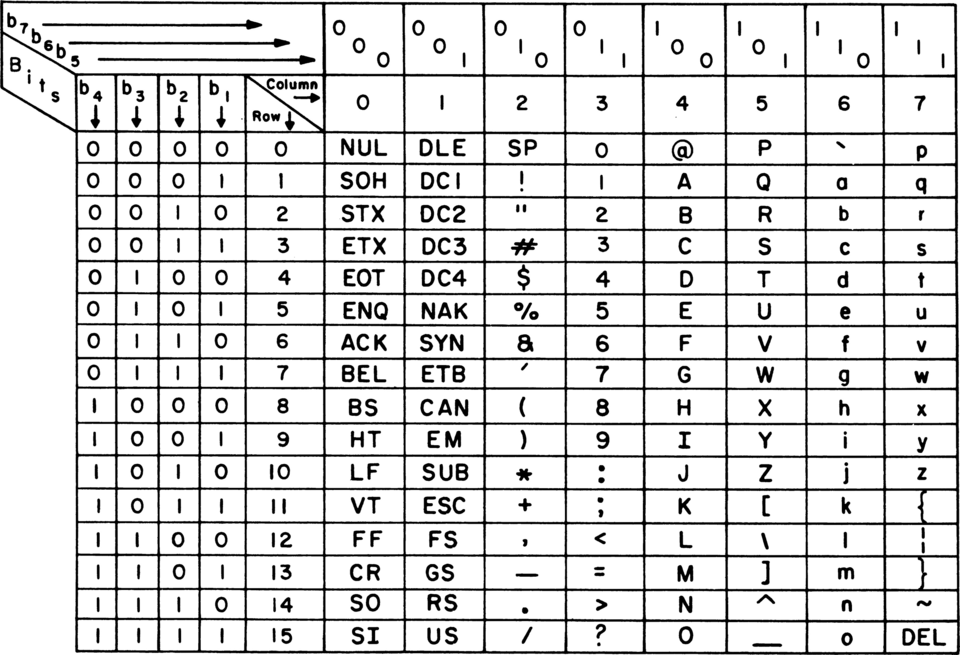
Sur la bande, chaque position de trou est un bit : 1 si le papier est percé, 0 sinon. Chaque trou de plus double le nombre de combinaisons, et sept trous en donnent 2 puissance 7, soit 128 : autant de numéros, de 0 à 127, un par caractère. La norme cite l'exemple du R, 1010010, soit le numéro 82.
Avec cinq trous, le vieux code Baudot des télégraphes ne connaît que 32 combinaisons et doit basculer entre un mode « lettres » et un mode « chiffres » ; un signal de bascule perdu, et toute la suite du message est fausse. Six bits donnent 64 combinaisons : assez pour un alphabet, dix chiffres et un peu de ponctuation, pas pour deux alphabets. Huit bits en donnent 256, mais chaque caractère coûte un bit de plus à transmettre, sur des lignes qui en font passer 110 par seconde. Le comité vote sept bits pour réduire le coût des transmissions, et laisse le huitième trou de la bande à la parité.
Cent vingt-huit cases, dont vingt-huit vides
La norme dessine les 128 numéros dans une grille de huit colonnes sur seize lignes : une case par numéro. Celle de 1963 réserve 36 cases à des codes de contrôle, des ordres qui ne s'impriment pas : sonner la cloche du téléscripteur, revenir en début de ligne, avancer le papier. Le retour chariot et le saut de ligne, codes 13 et 10, survivent dans chaque fichier texte de 2026. Le code 127, « effacer », est fait de sept trous poinçonnés : sur une bande de papier, c'est le seul moyen de rayer un caractère déjà frappé. Viennent ensuite l'espace, la ponctuation, les dix chiffres, puis les 26 majuscules. Pas de minuscules : 28 cases restent vides, réservées à une normalisation future ; deux flèches occupent les places du circonflexe et du tiret bas. Les minuscules n'entreront dans la norme qu'en 1967, dans les colonnes 6 et 7 de la table, à un seul bit d'écart de leurs majuscules. La grille de 1967 n'a plus de case vide : 95 caractères imprimables, espace compris, et 33 codes invisibles, les 32 ordres des deux premières colonnes plus le 127.
IBM vote pour, puis livre autre chose
Le revers arrive moins de dix mois après la publication. Le 7 avril 1964, IBM annonce le System/360. IBM siégeait au comité et avait porté la norme par la voix de Bemer. Le 360 n'utilise pas ASCII. Il parle EBCDIC, un code maison à huit bits hérité des cartes perforées, dont les lettres ne se suivent même pas : entre le I et le J, sept cases vides. Les perforatrices de cartes compatibles ASCII n'étaient pas prêtes pour le lancement, alors IBM a gardé son code. Le 360 se vend, et son alphabet avec lui. Bemer, lui, a quitté IBM en 1962. L'entreprise a aidé à écrire le standard, puis a bâti son succès à côté.
Il faut un président pour trancher. Le 11 mars 1968, Lyndon Johnson signe un mémorandum adressé aux chefs des départements et agences fédérales, qui parle de « nos vastes systèmes fédéraux d'ordinateurs et de télécommunications » et de leur « coûteuse incompatibilité ».
Tous les ordinateurs et équipements associés entrant dans l'inventaire du gouvernement fédéral à compter du 1er juillet 1969 devront être capables d'utiliser le Standard Code for Information Interchange.
L'État fédéral vient de choisir son alphabet. ASCII restera le codage le plus répandu sur le web jusqu'en décembre 2007.
Le é n'a pas de case
Lue avec un œil français, la grille de 1967 a un trou : pas de é, pas de è, pas de ç, pas de à. Le mot « américain » lui-même ne s'y écrit pas. Le reste du monde bricole. L'ISO reprend la norme en 1967, sous le nom d'ISO 646, et laisse douze cases ouvertes aux usages nationaux. La France publie sa variante, NF Z 62-010, en 1973 : l'arobase devient à, le crochet ouvrant devient °, la barre oblique inverse devient ç, le crochet fermant devient §, les accolades deviennent é et è, la barre verticale devient ù. Un programme en C relu sur un terminal réglé pour le français montre des é et des è là où le programmeur a tapé des accolades, et la fin de ligne « \n » s'affiche « çn ».
Le huitième bit finit par servir. En 1985, les constructeurs européens publient ECMA-94, que l'ISO adopte en 1987 sous le nom d'ISO 8859-1 : 256 cases, les 128 premières identiques à ASCII, les suivantes pour les accents d'Europe de l'Ouest. Le é obtient un numéro, 233. Le œ, lui, est écarté : le délégué français aurait soutenu qu'il s'agissait d'une simple ligature, et le délégué canadien, qui voulait le garder, aurait été débouté. Dans cette famille de normes, il faudra attendre ISO 8859-15, en 1999, pour écrire « cœur » sans tricher.
Un set de table dans le New Jersey
Unicode 1.0 paraît en octobre 1991 : un numéro pour chaque caractère de chaque écriture, et les 128 premiers numéros copiés sur ASCII, case pour case. Reste à ranger ces numéros dans des octets sans casser trente ans de fichiers à sept bits. Le 2 septembre 1992, Ken Thompson et Rob Pike, du groupe Plan 9 des Bell Labs, dînent dans un diner du New Jersey. Un comité de X/Open leur a soumis un projet de codage ; ils le trouvent incapable de se resynchroniser au milieu d'un flux. Thompson prend un set de table et y dessine les motifs de bits.
UTF-8 a été conçu, sous mes yeux, sur un set de table dans un diner du New Jersey, un soir de septembre 1992, à peu près.
Tout caractère ASCII s'écrit sur un octet, inchangé. Tout le reste s'écrit sur deux, trois ou quatre octets, dont aucun ne peut être confondu avec un caractère ASCII. La nuit même, Thompson écrit le code qui empaquette et dépaquette ; Pike reprend les bibliothèques C et graphiques ; le vendredi, Plan 9 ne tourne plus qu'en UTF-8. X/Open adopte le résultat, présenté à la conférence USENIX de San Diego en janvier 1993.
UTF-8 dépasse ASCII sur le web en décembre 2007. Google, qui compte à part les pages en ASCII pur, le voit approcher la moitié des pages en 2010 et passer 60 % en 2012. En octobre 2026, 99,1 % des sites l'utilisent. Unicode 18.0, publié le 16 septembre 2026, compte 172 808 caractères, des kanjis aux émojis. Chacun des 128 premiers s'écrit encore exactement comme en 1967. Le e de ce paragraphe pèse un octet, la case 101 de la grille du comité X3.2. Le é en pèse deux, 0xC3 0xA9 : le huitième trou, celui que le comité avait laissé à la parité, annonce maintenant qu'un second octet suit.
La bande de papier a disparu, le Teletype aussi. Mais chaque lettre sans accent qui traverse Internet voyage toujours dans les sept trous de 1963. Le é, lui, a d'abord pris la place d'une accolade, puis attendu le huitième bit. Il paie encore double.