Le vendredi 25 août 2006, Jeff Barr publie un billet sur le blog d'Amazon Web Services. Le billet s'intitule « Amazon EC2 Beta ». Le texte propose un serveur, l'équivalent d'un Xeon à 1,7 GHz avec 1,75 Go de mémoire et 160 Go de disque, facturé 10 cents de l'heure, sans engagement ni bon de commande. On s'inscrit, on envoie une image de système d'exploitation, on la démarre. On en démarre vingt si on veut, c'est la limite par compte pendant la bêta. Quand on a fini, on éteint, et la facture s'arrête.
Pour le reste du monde, Amazon reste une librairie en ligne qui vend aussi des grille-pain. Le mot « cloud » figure dans le nom du produit, Elastic Compute Cloud, mais presque personne ne sait encore ce qu'il désigne.
Quinze cents le gigaoctet
EC2 n'est pas le premier coup. Le mardi 14 mars 2006, Amazon avait ouvert S3, Simple Storage Service, avec un communiqué daté de Seattle et un tarif d'une ligne : 15 cents par gigaoctet et par mois, 20 cents par gigaoctet transféré. Andy Jassy, alors vice-président d'Amazon Web Services, y résumait l'intention en une phrase.
Amazon S3 repose sur l'idée qu'un stockage Internet de qualité devrait aller de soi.
Le mécanisme est celui d'une consigne de gare. On dépose un paquet, un fichier de 5 Go au maximum à l'époque, on reçoit un ticket, la clé, et on récupère le paquet plus tard en présentant le ticket, depuis n'importe où, par une simple requête HTTP. Pas de disque à acheter, pas de RAID à configurer, pas de sauvegarde à planifier : Amazon garde le paquet en plusieurs exemplaires, et on paie au poids. Derrière, le premier S3 tenait dans quinze baies réparties sur trois centres de données, 400 machines de stockage, un pétaoctet environ. C'est l'infrastructure qu'Amazon avait bâtie pour sa boutique, ouverte aux autres.
Le mémo qui a tout précédé
Vers 2002, Jeff Bezos impose en interne une règle que Steve Yegge, un ancien d'Amazon, racontera de mémoire en octobre 2011 dans un texte publié par erreur sur Google+ : toutes les équipes exposent leurs données et leurs fonctions par des interfaces de service, aucune autre forme de communication n'est tolérée, et chaque interface doit être conçue pour pouvoir, un jour, s'ouvrir à l'extérieur.
Quiconque ne s'y plie pas sera licencié. Merci, et bonne journée.
Yegge précise que la dernière phrase était une plaisanterie de son cru et que l'avant-dernière ne l'était pas. En 2003, lors d'un séminaire de direction chez Bezos, l'équipe liste ce qu'Amazon sait vraiment faire et découvre qu'elle est devenue bonne à faire tourner du calcul, du stockage et des bases de données à grande échelle. La même année, deux ingénieurs, Chris Pinkham et Benjamin Black, rédigent une note sur une infrastructure entièrement automatisée et glissent, vers la fin, l'idée de vendre des serveurs virtuels. Pinkham veut rentrer en Afrique du Sud. Amazon ouvre pour lui un bureau au Cap en décembre 2004, et c'est là, à une quinzaine de personnes, qu'EC2 est construit sur l'hyperviseur libre Xen, en vingt et un mois.
Le mythe des serveurs de Noël
Une légende tenace veut qu'AWS soit né d'un surplus : Amazon achetait des serveurs pour tenir la pointe de décembre, ils dormaient onze mois sur douze, autant les louer. L'histoire est jolie, et elle est fausse. Werner Vogels, directeur technique d'Amazon, l'a écrit sur Quora en 2010.
L'histoire de la capacité excédentaire est un mythe. Il n'a jamais été question de vendre du surplus : deux mois après le lancement, AWS aurait déjà épuisé toute la capacité en trop d'Amazon.com.
Vogels ajoute qu'AWS a été pensé dès le départ comme une activité à part entière, qui pourrait devenir aussi grosse que le commerce de détail. Le vrai ressort n'est pas le surplus, c'est l'échelle : acheter des machines par dizaines de milliers coûte moins cher à l'unité, et une interface de programmation permet de les découper en tranches d'une heure sans qu'un humain décroche le téléphone.
Un mot prononcé seize jours avant
Le 9 août 2006, à San José, Eric Schmidt, patron de Google, répond aux questions d'une conférence sur les moteurs de recherche. Il décrit un modèle où les données et les applications vivent sur des serveurs, quelque part, accessibles depuis n'importe quel appareil : « We call it cloud computing. » L'expression n'est pas neuve, un document interne de Compaq l'employait déjà en novembre 1996, mais c'est à partir de là qu'elle se répand. Seize jours plus tard, le service d'Amazon arrive avec le mot dans son nom. Le nom existait ; la catégorie, louer des machines à l'heure par une API, n'en avait pas encore. Microsoft mettra Azure en vente le 1er février 2010. Google ouvrira App Engine en avril 2008 et ne proposera des serveurs virtuels comparables qu'en 2012.
La carte de crédit et le mardi noir
En avril 2008, Animoto, qui fabrique des diaporamas vidéo, modifie son application Facebook. Lundi, 25 000 utilisateurs. Mardi, 50 000. Jeudi, 250 000. Le mois précédent, elle tournait sur 50 à 100 serveurs EC2 ; le vendredi matin, elle en fait tourner 3 400. Aucune jeune société n'aurait pu acheter, livrer et câbler 3 400 machines en quatre jours. Elle n'a eu qu'à les demander. La même année, en août, Netflix perd trois jours d'expédition de DVD à cause d'une base de données corrompue et décide de quitter ses propres centres de données ; la migration vers AWS s'achèvera en janvier 2016, après sept ans.
La dépendance a un revers. Le mardi 28 février 2017, à 9 h 37, heure du Pacifique, un ingénieur de S3 exécute une commande de routine pour retirer quelques serveurs d'un sous-système de facturation. Un paramètre est mal saisi, et un bien plus grand nombre de serveurs disparaît, dont ceux qui tiennent l'index des objets de la région de Virginie du Nord, la plus ancienne d'AWS. Pendant un peu plus de quatre heures, Slack, Trello, Quora et bien d'autres affichent des erreurs. Le tableau de bord d'état d'AWS, lui-même dépendant de S3, reste incapable de signaler la panne service par service pendant deux heures. Le 7 décembre 2021, même région, même jour de la semaine : une opération automatique sature le réseau interne et prive les clients de leurs consoles de 7 h 30 à 14 h 22. Une consigne de gare, c'est pratique, tant que le guichet est ouvert.
Ce que valent les étagères
Les chiffres de marché circulent plus vite que leurs sources. Gartner estimait les dépenses mondiales de cloud public à 595,7 milliards de dollars en 2024 et en prévoyait 723,4 milliards pour 2025, dans sa note de novembre 2024. Synergy Research, qui ne compte que l'infrastructure, mesurait 143,4 milliards de dollars pour le seul deuxième trimestre 2026, avec Amazon à 28 %, Microsoft à 20 % et Google à 15 %. Chez Amazon, en 2025, AWS a réalisé 128,7 milliards de chiffre d'affaires, 18 % du groupe, et 45,6 milliards de résultat d'exploitation sur 80, soit 57 %.
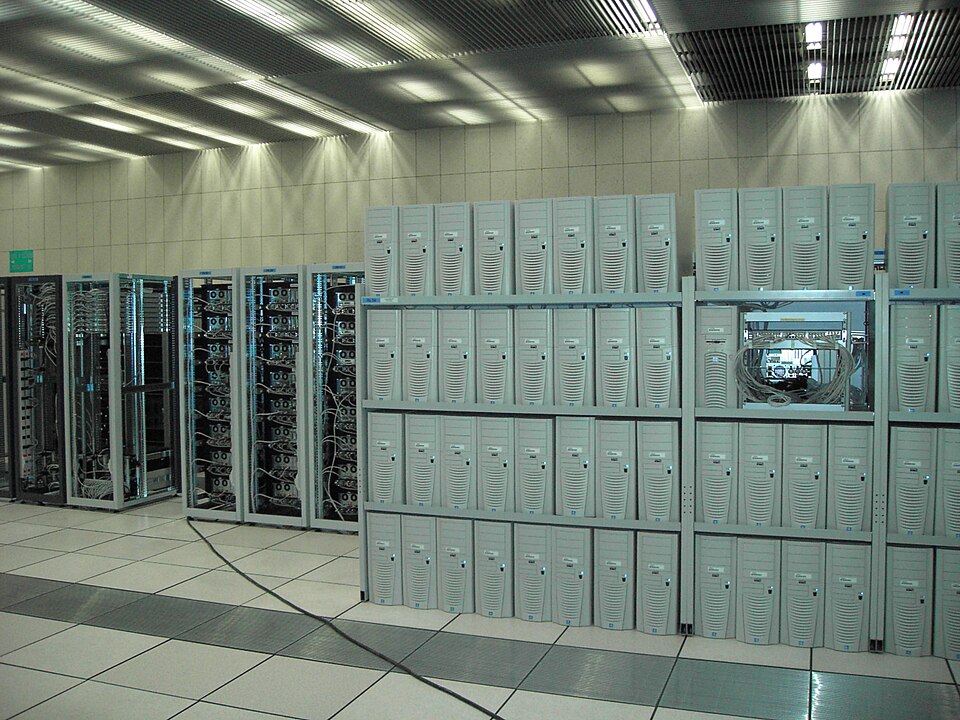
Le 6 juillet 2006, entre le lancement de S3 et celui d'EC2, une photographie est prise dans une salle de serveurs du CERN. On y voit des tours de PC beiges empilées sur des rayonnages métalliques, des câbles qui pendent, un faux plancher. C'est à ça que ressemblait un cloud cette année-là : des ordinateurs de bureau sur des étagères, et quelqu'un, à Seattle, qui a eu l'idée de les louer à l'heure.
Le gigaoctet qui valait 15 cents en mars 2006 se loue un peu plus de 2 cents aujourd'hui, et S3 annonçait en mars 2026 plus de 500 000 milliards d'objets stockés. Le serveur unique à 10 cents de l'heure est devenu un catalogue de plus de 1 200 types de machines. Le principe, lui, n'a pas bougé d'un mot : un ticket, un paquet, une facture au compteur.